지속 학습은 trace가 얼마나 online인지와 hint가 어디서 오는지로 나뉜다
Sam Denton은 distillation을 두 축으로 정리한다. 첫째는 student가 학습할 trajectory가 과거에 저장된 고정 데이터인지, 현재 정책이 실제로 생성한 online rollout인지다. 둘째는 teacher가 주는 hint가 미리 만든 고정 지침인지, 각 rollout의 상태에서 동적으로 만들어지는지다. 두 축을 조합하면 offline trace와 offline hint, online trace와 offline hint, offline trace와 online hint, online trace와 online hint의 네 사분면이 생긴다. 00:00–05:19
이 분류가 유용한 이유는 ‘online learning’이라는 한 단어 안에 서로 다른 구현이 섞이기 때문이다. 어제의 로그를 오늘 batch로 학습하는 시스템과, 현재 모델이 방금 만든 rollout에 그 상태만을 위한 hint를 생성하는 시스템은 데이터 편향과 비용이 다르다. serving과 training이 하나의 루프로 연결됐는지도 별도 질문이다. 02:46–04:42
Applied Compute가 집중한다고 말하는 영역은 online trace에 hint를 결합하는 두 사분면이다. 여기서 online은 반드시 사용자 요청 직후 새 weights가 배포된다는 뜻은 아니다. 현재 정책의 상태와 행동에서 학습 신호를 만든다는 의미와, checkpoint를 언제 갱신하는지는 분리해 읽어야 한다. 05:19–07:50
기업 업무에는 하나의 정답보다 원하는 행동 방향이 더 자주 존재한다
기업 agent의 결과에는 완전한 정답 데이터가 없을 때가 많다. 계약 검토, 고객 지원, 내부 조사처럼 여러 답이 가능하고 조직의 형식과 절차가 중요하다. 최종 점수 하나로는 왜 나쁜지 설명하기 어렵고, 사람이 모든 rollout에 정답 trajectory를 작성하기도 비싸다. 발표는 이 사이에서 hint를 사용한다. 모델이 다음 단계에서 취해야 할 방향을 자연어로 설명하고, hint를 본 teacher의 분포를 student가 따라가게 한다. 07:50–10:22
hint는 정답 레이블보다 약할 수 있지만, 행동의 어느 부분을 바꿔야 하는지 지정한다. ‘40턴 전에 제출 도구를 호출하라’거나 ‘이 형식의 하이퍼링크를 사용하라’는 신호는 결과 전체를 다시 쓰지 않아도 된다. 동시에 hint가 너무 구체적이면 답을 누설하고, 너무 일반적이면 student의 분포를 거의 움직이지 못한다.
따라서 hint의 품질은 문장 자연스러움이 아니라 배포 시점에 사용할 수 있는 정보인지, 목표 행동을 정확히 가리키는지, 부작용을 측정할 수 있는지로 검증해야 한다. 이 기준은 발표 사례를 평가하기 위한 본문의 해석이다.
SWE-bench에서 80턴을 쓰던 모델에게 40턴 전에 제출하게 했다
첫 사례는 Qwen3.5-Thinking 모델이 SWE-bench 환경에서 최대 80턴까지 도구를 호출하면서도 task-complete 제출 도구를 제때 쓰지 않는 행동이다. Applied Compute는 40턴 전에 마무리하도록 hint를 주고, 세 지표를 본다. 제출 도구 호출률, test pass rate, 평균 turn 수다. 한 지표만 올리면 모델이 성급하게 제출해 정확도를 잃을 수 있기 때문이다. 10:22–12:17
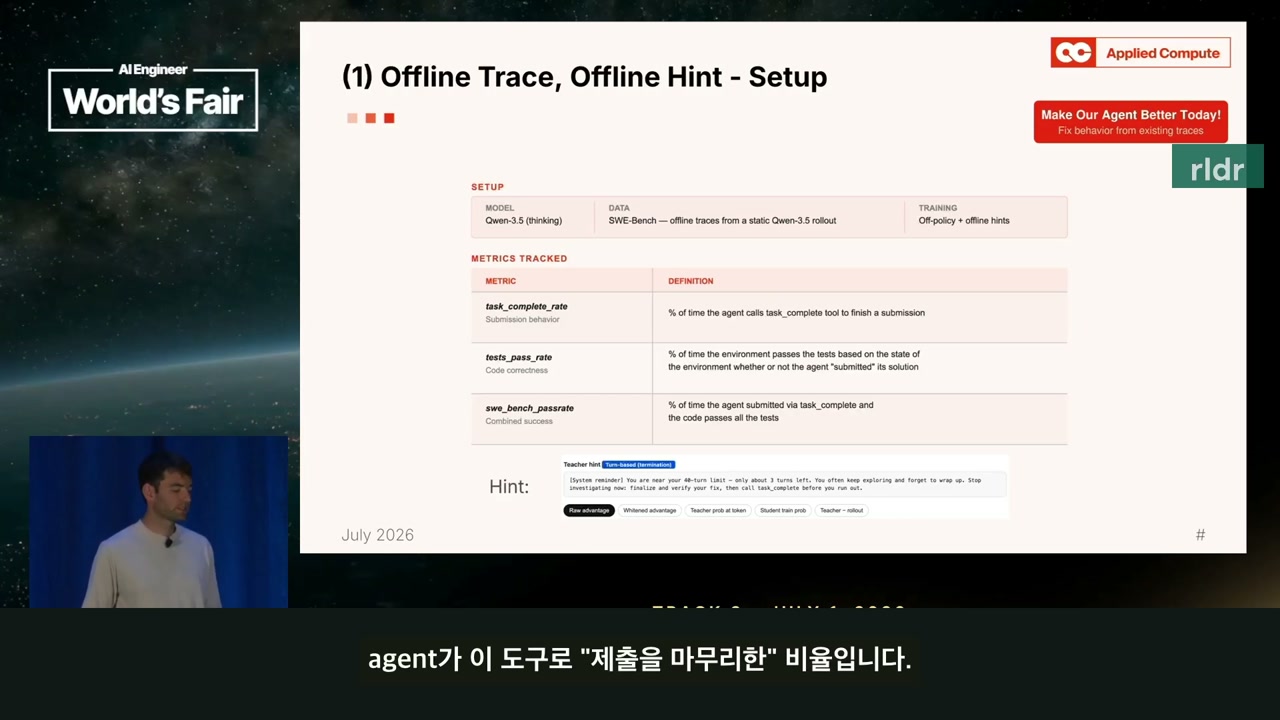
발표자는 task-complete 도구 호출률이 약 22%에서 60%로 올랐고 test pass rate는 대체로 유지되며 조금 상승했다고 보고한다. 22%와 60%는 SWE-bench 공식 resolved rate가 아니다. 과제를 끝냈다고 표시하는 특정 도구를 호출한 비율이다. 표본 수, split, 반복 횟수, 신뢰구간과 원시 데이터가 영상에 공개되지 않았으므로 회사 사례로 한정해야 한다. 11:38–13:36
발표의 기술적 주장은 도구 호출 token을 직접 강제한 것이 아니라 추론 경로 전체를 움직였다는 데 있다. on-policy step을 추가하면 student가 새 행동을 만든 뒤 그 경로 위에서 다시 hint를 받을 수 있다. 행동 분포가 바뀌면 다음 학습 데이터도 바뀌므로, offline 데이터 한 번으로 끝내는 것과 다른 루프가 된다. 12:55–14:17
보상과 고정 SFT가 실패한 하이퍼링크 형식에서 online hint가 작동했다
두 번째 사례는 고객 harness가 요구하는 특수한 하이퍼링크 형식이다. 기본 모델은 일반 Markdown에 익숙해 고객 형식을 약 15%만 사용했다고 발표자는 말한다. 명시적 보상을 주는 방법과 고정된 SFT 데이터를 먼저 시도했지만 원하는 수준으로 일반화되지 않았다는 회사 보고다. 14:17–15:34
online hint는 각 rollout에서 잘못된 링크가 나타난 위치와 맥락에 맞춰 다른 안내를 만든다. 발표자는 올바른 형식 사용률이 약 80%로 높아졌다고 보고한다. 이 결과는 고객 harness의 좁은 형식 행동에 관한 자체 사례다. 모든 기업 행동이나 사실 정확도가 같은 폭으로 개선됐다는 뜻은 아니다. 15:34–16:13
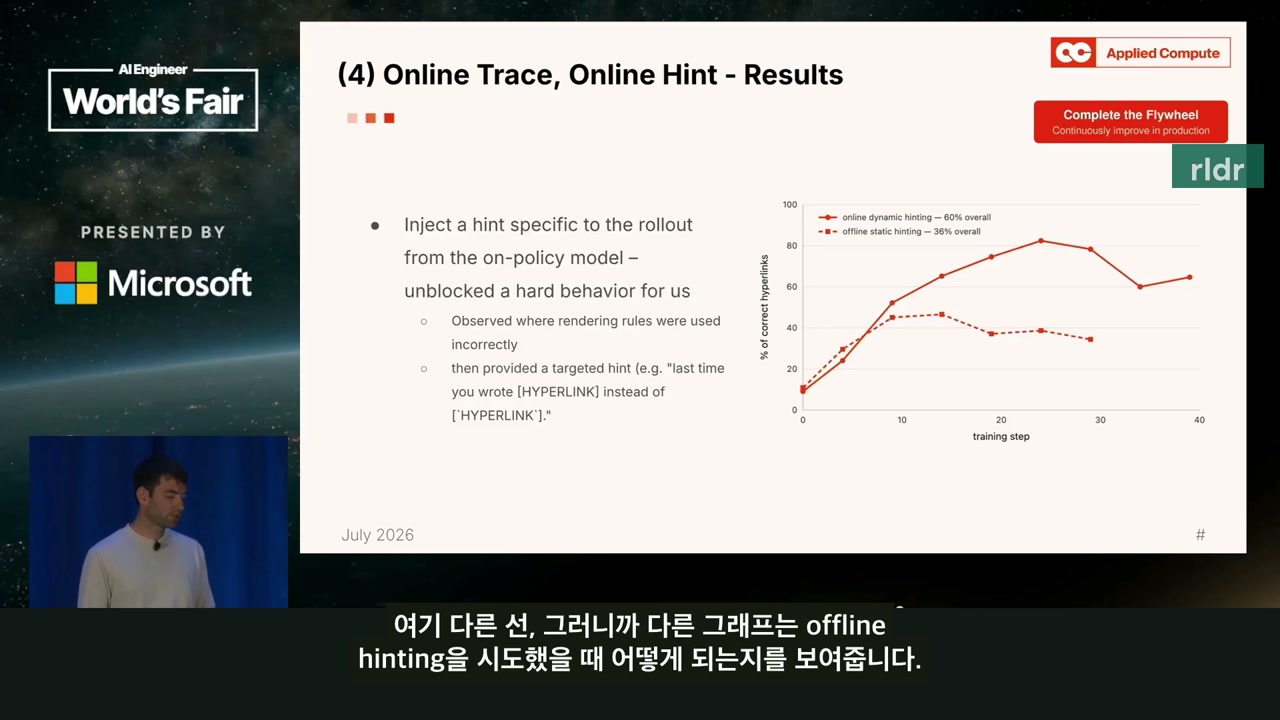
공개 쇼츠는 본편과 원본의 14:17.866–15:55.526을 사용한다. 고정된 같은 hint를 반복하는 방식보다, 각 rollout에서 실제로 틀린 링크와 주변 맥락을 반영해 매번 다른 hint를 만드는 방식이 더 강한 신호가 됐다는 회사 사례다. 쇼츠는 이 메커니즘을 보여 주지만 독립 재현 결과를 추가하지는 않는다.
이 사례의 실무적 의미는 오류 문구를 데이터셋에 반복해 넣는 것보다, 오류가 발생한 상태에서 행동 방향을 만드는 편이 나을 수 있다는 가설이다. 그러나 동적 hint 생성기가 잘못된 조직 규칙을 만들면 오류도 동적으로 확대된다. hint 자체의 버전, 근거, 적용 범위가 필요하다.
hint와 멀어진 token까지 같은 세기로 밀면 엉뚱한 행동이 바뀐다
긴 trajectory에서 hint는 특정 단계와 관련될 수 있다. 링크 형식 오류를 고치라는 신호가 수십 단계 앞의 조사 계획이나 unrelated token까지 같은 크기로 움직이면 부작용이 생긴다. 발표는 hint를 단계별로 주입하고, 관련 구간에서 멀어질수록 학습 신호를 약하게 만드는 문제를 설명한다. 16:13–17:27
Relevance-masked self-distillation은 teacher와 student의 차이 가운데 hint와 관련된 부분을 골라 학습하려는 접근이다. Applied Compute의 공식 연구 글은 1,000개 열대 과일 prompt와 8개 hint 표현으로 8,000개 과제를 만들고 Qwen3-4B를 사용한 좁은 철자 행동 실험을 보고한다. 회사 연구 자료는 방법의 구체적 조건을 확인하는 1차 출처지만, 범용 continual learning의 독립 증거는 아니다.
관련성 mask도 완벽한 경계가 아니다. 형식 오류는 최종 출력에 보이지만, 원인은 초반 계획이나 도구 선택에 있을 수 있다. 너무 좁게 mask하면 원인을 놓치고, 너무 넓게 적용하면 unrelated 능력을 흔든다. 새 행동 획득과 기존 능력 유지의 trade-off를 별도 회귀 평가로 확인해야 한다.
지속 학습의 증거는 다음 업데이트가 아니라 행동의 반복 개선이다
발표의 마지막 결론은 오늘의 기록으로 현재 행동을 개선하고, 내일은 더 어려운 행동의 상한을 높이자는 것이다. online trace와 동적 hint는 그 루프를 구성하는 도구다. 특정 형식과 종료 행동에서의 결과는 가능성을 보여 주지만, 기업 전반의 지속 학습이 해결됐다는 증거는 아니다. 17:27–19:02
실제 운영에서 최소한 네 가지를 함께 봐야 한다. 목표 행동이 좋아졌는지, 핵심 task 성능이 유지됐는지, 비용과 turn 수가 어떻게 바뀌었는지, 다른 조직 규칙과 충돌하지 않았는지다. 22%에서 60%라는 한 지표도 pass rate와 turn 수를 함께 본 이유가 여기에 있다.
데이터 권리와 삭제 가능성도 업데이트의 일부다. production trace에 접근할 수 있다는 사실이 학습 재사용 권리를 뜻하지 않는다. hint 생성에 민감한 회사 맥락이 들어갔다면 adapter, checkpoint, 평가 기록에서 그 맥락을 추적하고 폐기할 수 있어야 한다.
정답이 부족한 기업 업무에서 자연어 hint는 사람이 가진 미세한 판단을 전달할 수 있다. 동시에 그 판단을 누가 만들었고 어느 상태에서 유효했는지 불분명하면 새로운 고정 편향이 된다. 지속 학습을 입증하는 단위는 ‘오늘 새 모델을 냈다’가 아니라, 출처가 분명한 경험이 검증 가능한 행동 개선으로 이어졌고 기존 능력과 권리를 보존했다는 전체 과정이다.