기업별 RL의 출발점은 공개 점수가 아니라 회사의 과제다
Applied Compute의 Rhythm Garg는 RL을 “현재 모델의 분포 밖에 있는 데이터를 분포 안으로 가져오는 도구”라고 설명한다. 그가 말하는 다음 단계는 공개 벤치마크의 점수를 더 올리는 데서 끝나지 않는다. 각 기업이 중요하게 여기는 자체 과제를 모델이 풀도록 만드는 일이다. 발표의 첫 문장은 이 영상의 나머지 논의를 이해하는 열쇠다.
이 표현은 기업의 모든 업무를 하나의 모델에 넣는다는 뜻이 아니다. 발표가 다루는 범위는 성공 여부를 채점할 수 있는 특정 과제를 고르고, 모델이 그 과제를 더 자주 성공하도록 가중치를 조정하는 학습이다. 공개 수학 문제 대신 고객사의 핵심 업무가 벤치마크가 된다는 주장이다. 어떤 입력을 주고 어떤 결과를 성공으로 볼지 먼저 정하지 않으면 “회사별 모델”이라는 말은 학습 문제로 바뀌지 않는다.
발표자의 주장은 Applied Compute가 공개 벤치마크용 RL의 원리를 고객 업무에 옮긴다는 것이다. 이 영상만으로 개별 고객 과제의 성능 향상, 비용 절감 폭, 일반화 성능을 독립적으로 확인할 수는 없다. 여기서 확인할 수 있는 것은 회사가 제시한 학습 구조와 그 구조가 납기와 GPU 활용률에 만드는 제약이다.
여러 풀이를 생성하고 채점한 뒤 성공한 행동을 강화한다
발표는 수학 문제 네 개를 예로 든다. GPT-OSS나 Llama 같은 공개 가중치 모델이 각 문제를 100번씩 풀고, 매 시도마다 추론 토큰과 최종 답을 만든다고 가정한다. 답을 채점한 뒤 정답을 만든 궤적의 가능성을 높이고 오답을 만든 행동은 억제한다. 이 단계를 반복하며 문제 풀이 행동을 학습한다는 설명이다. 네 문제와 각 100개 샘플의 예시는 0:37부터, 보상에 따른 가중치 조정은 1:05부터 나온다.
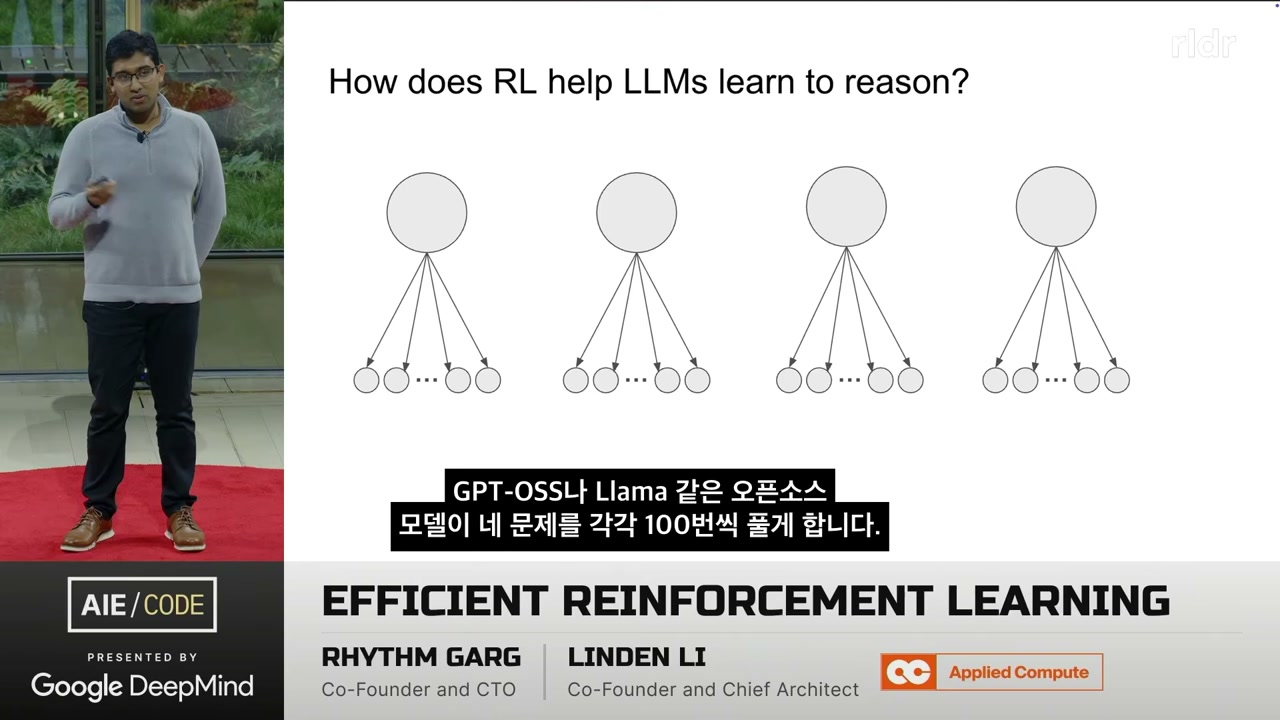
이 도식은 이해를 위한 축약이다. 실제 RL 학습에서는 보상값만 정한다고 끝나지 않는다. 어떤 정책에서 샘플을 만들었는지, 한 번의 업데이트에 어떤 표본을 묶는지, 정책 변화가 지나치게 커지지 않도록 무엇을 제한하는지까지 알고리즘이 정해야 한다. 발표는 이 가운데 뒤에서 문제가 되는 샘플 생성과 정책 업데이트의 시간 관계에 집중한다.
영상은 GRPO라는 알고리즘 이름을 쓰지 않는다. 다만 여러 풀이를 묶어 상대적 보상 신호를 만드는 접근을 더 읽고 싶다면 DeepSeekMath 논문이 1차 자료다. 이 논문은 GRPO를 PPO의 변형으로 소개하고, 수학 추론 성능과 PPO의 메모리 사용량을 개선하려는 방법으로 설명한다. 이는 영상 속 네 문제 예시의 알고리즘을 GRPO라고 식별한 것이 아니라, 여러 응답과 보상을 이용한 추론 학습의 한 구체적 방법을 덧붙인 독립 자료다.
기업용 학습에서는 처리량과 함께 납기 편차를 줄여야 한다
연구소의 대규모 학습은 몇 주 동안 계속될 수 있다. Garg는 Applied Compute의 고객별 학습에는 다른 운영 조건이 붙는다고 말한다. 모델을 학습해 며칠 안에 고객에게 전달하려면 실행이 빨라야 하고, 사업을 지속하려면 비용이 낮아야 하며, 소요 시간의 분산도 작아야 한다. 평균적으로 빠른 실행이 가끔 크게 늦어진다면 고객에게 일관된 납기를 약속하기 어렵다는 설명이다. 세 조건은 2:04–2:47에 제시된다.
여기서 평균 학습 시간만 보면 문제를 놓친다. 고객별 실행은 데이터 크기, 응답 길이, 채점 시간, 오류와 재시도에 따라 달라진다. 평균값이 좋아도 일부 실행의 꼬리가 길면 GPU 예약과 다음 작업의 시작 시점을 예측하기 어려워진다. 납기 편차는 기술 지표인 동시에 고객 일정과 인프라 원가를 흔드는 사업 지표가 된다.
이 글의 해석으로는 “빠르고 싸다”를 세 개의 측정값으로 나누는 편이 유용하다. 첫째는 유효한 학습 표본을 만드는 처리량, 둘째는 GPU가 실제 계산에 쓰인 비율, 셋째는 실행 완료 시간의 상위 백분위와 최대값이다. 평균 처리량만 최적화하면 긴 꼬리 샘플 때문에 생기는 대기를 감출 수 있다. 발표가 동기식 RL의 마지막 1%에 주목하는 이유도 여기에 있다.
동기식 배치는 가장 느린 샘플 하나의 시간을 따라간다
동기식 RL에서는 샘플 생성과 학습이 단계별로 맞물린다. 발표의 단순한 예에서는 한 배치에 샘플이 여덟 개 있고, 여덟 개가 모두 끝나야 학습을 시작한다. 일곱 개가 이미 준비됐더라도 마지막 샘플이 남아 있으면 학습 GPU는 기다린다. 한 단계의 시간은 평균 샘플이 아니라 가장 늦게 끝난 샘플이 결정한다. 여덟 개 배치의 대기 구조는 2:54부터 설명된다.
Garg는 내부 측정 사례도 제시한다. Qwen 30B로 산술 문제 40개에서 각각 32개 샘플을 생성했더니 전체 샘플의 99%는 약 40초 안에 끝났지만, 마지막 1%가 끝나는 데 80초가 더 걸렸다고 한다. 화면의 표에는 p99 40.9초, 최대 119.8초가 표시된다. 처음에는 샘플링 요청이 한꺼번에 돌아 GPU가 바쁘지만, 끝으로 갈수록 완료된 작업이 빠지고 마지막 요청만 남아 활용률이 떨어진다. 측정 조건은 3:27부터, 99%와 마지막 1%의 차이는 3:39부터 확인할 수 있다.
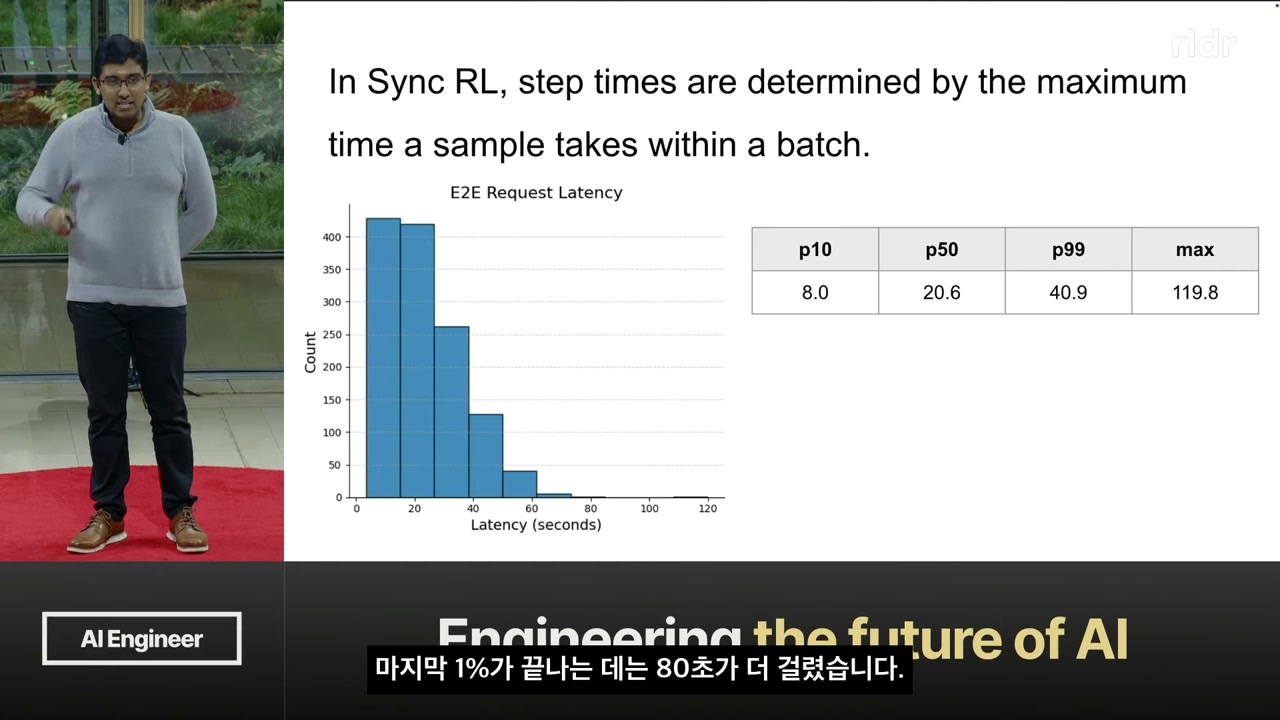
이 수치는 Applied Compute가 발표에서 공개한 내부 사례다. 실험 코드, 프롬프트, 생성 길이, 추론 설정이 함께 공개된 독립 재현 결과는 아니므로 모든 모델과 과제에 같은 비율이 나타난다고 일반화할 수 없다. 다만 동기식 장벽에서 가장 느린 작업이 전체 단계를 지연시킨다는 메커니즘은 수치와 별개다. 생성 길이가 들쭉날쭉한 언어 모델 작업에서는 이 장벽이 긴 꼬리 지연을 GPU 유휴 시간으로 바꾼다.
운영에서 확인할 질문도 구체적이다. 배치가 끝날 때 샘플러와 학습기가 각각 얼마나 쉬는가, 샘플 완료 시간의 p50과 p99 및 최대값은 얼마인가, 배치 크기를 키울 때 가장 느린 샘플의 영향이 얼마나 커지는가를 측정해야 한다. 병목이 마지막 샘플을 기다리는 장벽이라면 GPU를 더 추가해도 대기 구조 자체는 사라지지 않는다.
이 Short는 여덟 개 샘플의 동기식 배치와 마지막 1%의 지연을 설명하는 1분 20.8초 구간이다. 비동기 방식의 구현과 정책 버전 보정은 포함하지 않으며, 그 내용은 아래의 전체 하이라이트 설명으로 이어진다. 해당 Short 전체 구간
PipelineRL은 샘플 생성과 학습을 동시에 흐르게 만든다
비동기식 RL은 샘플 생성이 모두 끝나기를 기다린 뒤 학습하는 순서를 푼다. 발표에서 소개한 PipelineRL은 Piché 등이 제안한 기법으로, GPU 일부를 샘플링에, 나머지를 학습에 할당한다. 샘플링 워커는 큰 배치로 계속 추론하고, 끝난 샘플은 큐에 넣는다. 학습 워커는 큐에서 배치를 꺼내 가중치를 업데이트한다. 샘플링 GPU와 학습 GPU의 분리는 4:30부터 나온다.
핵심은 실행 중 가중치 갱신이다. 학습 워커가 한 배치의 업데이트를 마치면 새 가중치를 샘플링 워커에 보낸다. 샘플링 워커가 한 응답을 아직 생성하는 중이어도 다음 토큰부터 새 가중치를 사용할 수 있다. 샘플 생성과 학습을 겹쳐 놓으므로 한쪽이 전체 배치의 완료를 기다리는 시간을 줄일 수 있다. 큐와 실행 중 갱신은 4:42–5:10에 설명된다.
이 메커니즘은 PipelineRL 논문의 초록과도 일치한다. 논문은 비동기 데이터 생성과 모델 학습을 동시에 수행하고, 토큰 시퀀스를 생성하는 도중 가중치를 갱신해 가속기 활용률과 데이터의 최신성 사이의 균형을 개선한다고 설명한다. 논문의 128 H100 실험과 약 두 배 빠른 학습 결과는 해당 논문의 장문 추론 설정에서 나온 결과다. 이 발표의 고객별 실행이나 다른 하드웨어에서도 같은 배율을 보장하는 수치로 읽어서는 안 된다.
큐를 둔다고 모든 병목이 해결되는 것도 아니다. 샘플 생성률이 학습 소비율보다 높으면 큐가 길어져 오래된 샘플이 쌓일 수 있고, 반대면 학습 워커가 입력을 기다린다. 샘플러와 학습기에 GPU를 어떻게 나눌지, 큐의 최대 크기와 폐기 규칙을 어떻게 정할지, 가중치 배포가 실제로 얼마나 중단을 만드는지까지 함께 측정해야 한다. 비동기화는 대기를 없애는 마법이 아니라 대기의 위치와 형태를 바꾸는 설계다.
대기를 줄이면 한 응답 안에 여러 정책 버전이 섞인다
실행 중 가중치를 바꾸면 한 샘플이 하나의 정책으로만 생성되지 않는다. 발표의 예에서는 응답 생성 도중 학습과 가중치 갱신이 두 번 일어나 정책 t, t+1, t+2가 한 샘플의 서로 다른 토큰을 만든다. 이 샘플을 더 나중의 정책으로 학습하면 일부 토큰은 현재 학습 정책보다 여러 단계 오래된 정책에서 나왔다. 이를 정책 지연, 즉 staleness로 설명한다. 세 정책 버전이 섞이는 예시는 5:25부터 볼 수 있다.
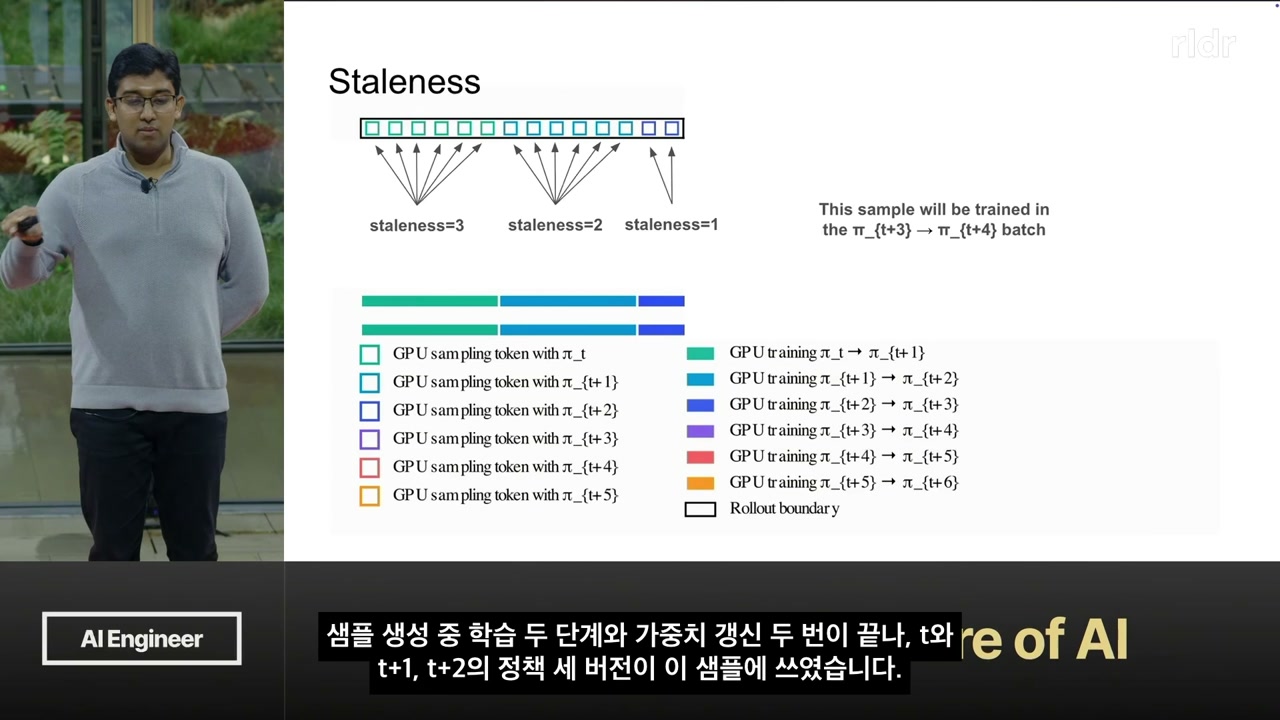
지연의 상한을 낮추면 데이터는 더 최신 상태에 가까워진다. 그러나 발표의 예처럼 최대 두 단계까지만 허용하면, 다음 가중치 갱신이 샘플의 지연을 세 단계로 만들 시점에 학습 워커가 멈춰야 한다. 샘플이 끝날 때까지 기다리고 나서야 다음 학습 배치를 시작한다. 상한을 한 단계로 더 줄이면 기다리는 시간은 늘어난다. 반대로 더 큰 지연을 허용하면 쉬는 GPU는 줄지만 현재 정책과 데이터를 만든 정책의 차이는 커진다. 지연 상한과 학습 워커의 대기는 5:54–6:31에 나온다.
여기서 “오래됐다”는 벽시계 시간이 아니라 정책 업데이트 횟수의 차이다. 같은 세 단계라도 업데이트 크기가 작으면 정책 차이가 작을 수 있고, 한 단계라도 업데이트가 크면 행동 확률이 크게 달라질 수 있다. 따라서 허용할 지연을 정할 때 단계 수와 함께 실제 정책 간 차이, 큐에 머문 시간, 응답 안에서 버전이 바뀐 위치를 기록해야 한다. 이는 발표의 원리를 운영 측정으로 풀어 쓴 해석이다.
중요도 비율은 정책 차이를 보정하지만 분산까지 없애지는 않는다
정책 지연이 생기면 데이터를 만든 행동 정책과 지금 업데이트하려는 목표 정책이 달라진다. 중요도 비율은 같은 행동에 두 정책이 부여하는 확률의 비를 이용해, 오래된 정책에서 얻은 표본을 목표 정책의 경사 추정에 맞게 다시 가중한다. Garg는 이 비율이 정책 경사의 편향을 없앤다고 설명한다. 중요도 비율의 역할은 6:33부터 나온다.
“편향을 없앤다”는 문장에는 조건이 붙는다. 목표 정책이 낼 수 있는 행동을 행동 정책도 충분히 표본화해야 하고, 사용한 확률과 표본이 정확해야 하며, 실제 구현에서 비율을 자르거나 정규화하면 다시 편향과 분산의 절충이 생긴다. 오래된 정책과 새 정책이 크게 다르면 소수의 표본에 매우 큰 가중치가 붙어 추정량의 분산이 커질 수 있다. 발표도 정책 지연이 커질수록 중요도 비율의 분산이 커지고 학습이 불안정해져 발산할 수 있다고 경고한다. 불안정성과 발산 위험은 6:50–7:02에 제시된다.
이로써 처음의 사업 요구가 알고리즘 문제로 돌아온다. 고객별 학습을 빨리 끝내려면 GPU 대기를 줄이고 더 큰 정책 지연을 허용하고 싶다. 안정적인 학습을 원하면 정책 차이를 작게 유지하고 싶다. 처리량, 데이터 최신성, 중요도 가중치의 분산을 동시에 관찰해야 하는 이유다. Applied Compute는 이 절충을 자사 핵심 연구 과제이자 사업과 직접 연결된 문제라고 말한다. 발표의 결론은 7:02–7:21이다.
실제 적용에서는 초당 생성 토큰이나 GPU 이용률만으로 성공을 판단하기 어렵다. 동일한 예산에서 목표 품질에 도달하는 시간, 학습 곡선의 변동, 발산과 재시작 빈도, 오래된 정책에서 생성된 토큰 비율을 함께 봐야 한다. 더 많은 비동기화로 처리량이 올라도 재학습과 실패가 늘면 고객 납기는 오히려 길어진다. 이 영상의 핵심은 비동기식 RL이 무조건 빠르다는 선언보다, 동기식의 꼬리 대기를 정책 지연과 안정성의 문제로 바꾼다는 데 있다.
Applied Compute의 학습 구조를 더 넓게 보려면 세 글을 이어 읽을 수 있다. 이번 글은 RL 학습 인프라의 속도와 안정성을 다룬다. 기업별 AI agent는 어떻게 업무를 배우는가는 회사별 과제, eval, reward, sandbox가 연결되는 구조를 설명한다. 실제 업무 trace에서 계속 배우는 조건은 운영 중 남은 trace와 사람의 hint를 다음 학습 신호로 바꾸는 조건을 다룬다. 세 주제를 한꺼번에 보고 싶다면 Applied Compute 종합 리서치에서 전체 맥락을 확인할 수 있다.
더 읽을 자료
- Applied Compute 발표 원본이 글은 원본 1:16.6–8:38.2 구간만 사용한다.
- RLDR 한국어 자막 공개본본문 시간 링크의 기준 영상. 공개 API의 길이 값은 아직 확정 근거로 쓰지 않았다.
- PipelineRL: Faster On-policy Reinforcement Learning for Long Sequence Generation비동기 생성과 학습, 실행 중 가중치 갱신을 확인한 1차 논문.
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language ModelsGRPO의 정의와 논문이 보고한 목적을 확인한 1차 자료. 영상은 GRPO라는 이름을 사용하지 않는다.
- Datafooding Applied Compute research note발표 맥락을 확인한 배경 자료. 이 글의 영상 범위 밖 수치는 가져오지 않았다.