보상 함수를 만들기 전에 좋은 결과부터 정의해야 한다
Yash Patil은 모델을 보상 함수로 학습할수록 ‘무엇이 좋은가’와 ‘무엇이 나쁜가’를 정하는 일이 중요해진다고 말한다. eval은 이 판단을 특정 과제와 측정값으로 바꾸는 장치다. 같은 입력에서 모델이 어떤 행동을 했는지 관찰하고, 그 결과가 기준을 얼마나 충족했는지 비교할 수 있어야 학습 방향이 생긴다. 좋고 나쁨을 먼저 알아야 한다는 설명은 0:18부터, eval의 정의는 0:31부터 나온다.
이때 eval은 마지막에 붙이는 점수표에 머물지 않는다. 어떤 실패를 모을지, 어떤 데이터를 학습에 넣을지, 어떤 개선을 다음 연구 과제로 삼을지를 정한다. Patil이 “eval이 로드맵을 정한다”고 표현한 이유다. 측정할 수 없는 목표는 reward로 옮기기 어렵고, 잘못 측정한 목표는 모델이 엉뚱한 방향으로 더 잘 최적화하게 만들 수 있다. eval과 로드맵의 관계는 0:40에 제시된다.
기업의 내부 지식을 모델에 넣는다는 말도 이 관점에서 다시 볼 필요가 있다. 문서와 데이터베이스를 검색하게 하는 것만으로는 회사가 원하는 결과가 정의되지 않는다. 실제 산출물 중 무엇을 승인하고 무엇을 고치는지, 어느 오류를 더 심각하게 보는지가 학습 가능한 판단 기준이 된다. 이는 발표의 메커니즘을 기업 시스템의 언어로 풀어 쓴 해석이다.
eval이 오를 언덕을 정하면 RL은 그 언덕을 오른다
Patil은 코딩 모델 경쟁의 사례로 SWE-bench를 든다. 이 벤치마크가 ‘유용한 코딩’에 가까운 목표를 제공했기 때문에 연구팀이 최적화할 대상을 얻었다는 설명이다. SWE-bench 사례는 0:47부터 나온다. 원 논문에서 SWE-bench는 실제 GitHub issue와 pull request에서 가져온 2,294개 문제를 12개 Python 저장소에 걸쳐 구성했고, 모델이 저장소를 수정해 문제를 해결하도록 평가한다. SWE-bench 원 논문
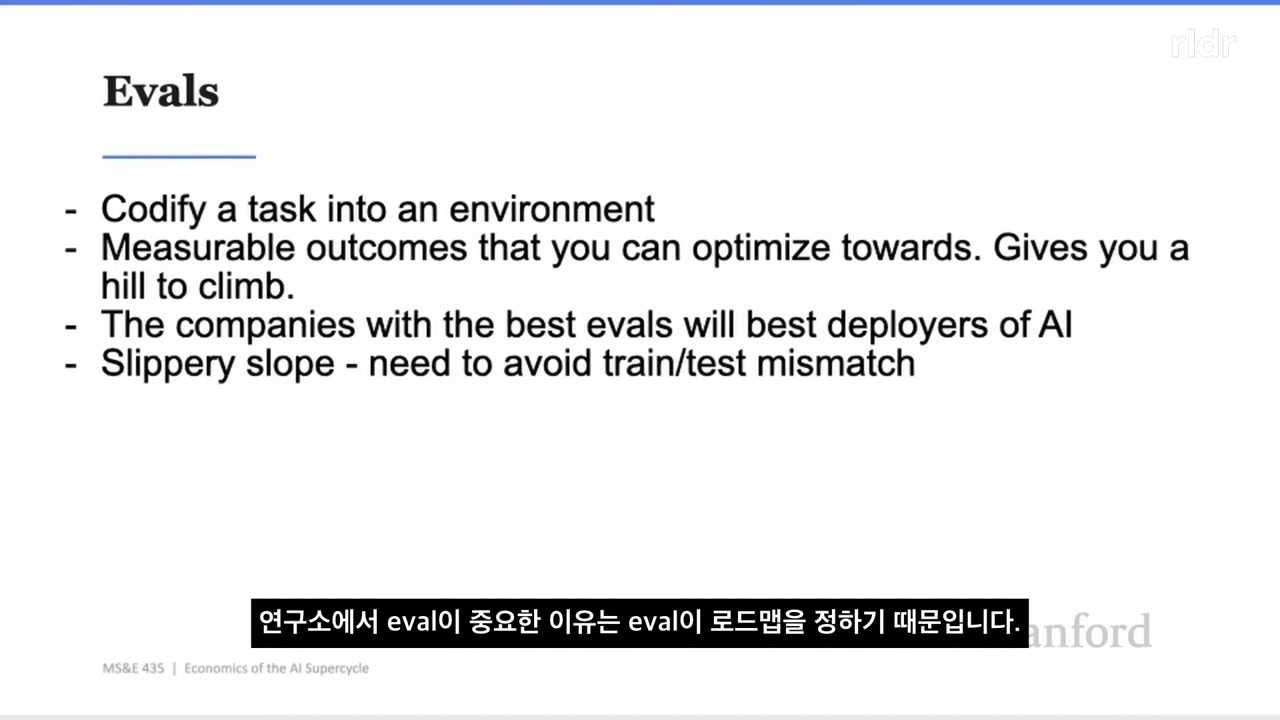
Patil은 동시에 SWE-bench에 결함이 많으며 이후 더 나은 eval이 나왔다고 평가한다. 이 발언의 핵심은 특정 벤치마크가 영구적인 정답이라는 데 있지 않다. 오를 언덕을 eval로 먼저 정의하고, RL로 그 점수를 높인 뒤, 더 나은 eval이 생기면 다음 언덕으로 옮겨 간다는 개발 순서를 설명한다. 결함에 대한 평가는 1:05, “eval을 극대화하는 기계”라는 RL 비유는 1:11에 이어진다.
점수를 높이는 일에는 두 경계가 필요하다. 슬라이드의 train-test mismatch는 학습에서 최적화한 과제와 평가에서 요구하는 조건이 어긋나는 문제를 가리킨다. 발표는 이와 별도로 eval 데이터 포인트에 직접 과적합하지 않도록 학습 파이프라인은 비슷하게 만들되 다른 데이터를 써야 한다고 말한다. 과제와 조건을 맞추는 일, 같은 평가 표본을 학습에 재사용하지 않는 데이터 분리는 연결돼 있지만 같은 조건은 아니다. eval과 같은 문제를 그대로 반복 학습시키면 일반화된 능력보다 정답 기억이나 측정 허점이 점수를 끌어올릴 수 있다. 따라서 좋은 eval에는 과제 정의, 측정 가능한 결과, 학습과 평가 조건의 정렬, 학습 데이터와 시험 데이터의 분리, 실패 유형의 갱신이 함께 필요하다. 학습 데이터 분리 조건은 1:20–1:31에 설명된다.
모델 연구소의 기준과 기업의 기준은 서로 다른 층에 있다
기업마다 같은 업무를 다르게 판단한다. Patil은 JPMorgan과 Goldman Sachs를 예로 들며 두 회사의 기준과 운영 방식이 같지 않으므로 자체 eval도 달라진다고 설명한다. 모델 연구소가 범용 능력을 위해 최적화하는 eval 위에, 기업이 실제 업무 결과를 위해 최적화하는 eval이 한 층 더 생긴다는 주장이다. 기업별 기준은 1:38, 두 층의 eval은 1:52에 나온다.
Patil은 Applied Compute를 이 두 층 사이의 ‘특화 계층’으로 설명한다. 기업별 eval을 만들고 그 기준에 맞춰 모델을 학습하도록 돕는다는 회사의 자기 설명이다. 특화 계층이라는 설명은 2:00에 제시된다. 영상은 이어서 Patil이 Rhythm Garg, Linden Li와 회사를 시작했고 세 사람이 OpenAI에서 함께 일했다는 창업 배경을 짧게 다룬다. 이 이력은 회사가 내세우는 문제의 출발점을 보여 주지만, 고객 성과를 독립적으로 증명하지는 않는다. 공동 창업 배경은 2:24–2:51에서 들을 수 있다.
회사의 핵심 논지는 범용 모델이 모든 기업의 출발선을 높이더라도, 경쟁사를 앞서는 상한선은 기업별 기준과 시스템에서 생긴다는 것이다. 범용 모델을 그대로 쓰는 것과 기업이 기초 모델을 처음부터 만드는 것 사이에, 기존 모델을 자체 eval과 피드백으로 특화하는 선택지가 있다는 뜻이다. 범용 모델이 바닥을, 특화 시스템이 천장을 정한다는 설명은 2:51–3:21에 나온다.
메뉴 이미지를 매장 페이지로 바꾸려면 회사 규칙을 알아야 한다
Patil이 든 사례는 DoorDash의 가맹점 입점 과정이다. 그는 DoorDash가 매년 10만 곳이 넘는 가맹점을 플랫폼에 입점시킨다고 말한다. 이 수치는 발표자의 설명이며 영상 안에 산정 기간이나 원자료는 제시되지 않는다. 입점하는 가맹점은 메뉴를 비롯한 비정형 정보를 보내고, 시스템은 메뉴 이미지에서 구조화된 매장 페이지를 만들어야 한다. 10만 곳이라는 발표는 3:47, 메뉴 추출 과제는 3:52–4:12에 나온다.
어려움은 글자를 읽는 데서 끝나지 않는다. 메뉴 항목에 어떤 옵션을 붙일지, 어떤 조합을 허용할지, add-on과 특별 재료를 어떻게 구분할지 같은 DoorDash 고유의 스타일 가이드가 있다. 같은 문구라도 회사 규칙에 따라 올바른 구조가 달라질 수 있다. Patil은 범용 모델과 프롬프트 조정만으로는 이 과제를 제대로 해결하지 못했다고 보고한다. 세부 규칙은 4:13, 범용 모델과 프롬프트의 한계는 4:26–4:36에 설명된다.
사용한 모델 유형은 VLM이다. 발표자는 Transformer 구조를 쓰는 시각 모델이라고 짧게 설명한다. 이미지와 텍스트를 함께 처리할 수 있어야 메뉴 사진을 구조화할 수 있지만, 시각 입력을 받는 능력만으로 회사의 분류 규칙까지 자동으로 알게 되는 것은 아니다. VLM 확인은 5:37–5:43에 나온다.
이 Short는 메뉴를 회사 규칙에 맞추기 어려운 이유부터 사람의 수정 차이를 손실이나 보상으로 바꾸는 과정까지 담은 1분 29.8초 구간이다. 이어지는 다음 절에서 학습 과정을 자세히 설명한다. 연간 10만 곳이라는 수치는 여기서도 화자의 주장이다. 해당 Short 전체 구간
사람의 수정 차이를 ground truth와 reward로 바꾼다
해결 과정은 사람의 수정에서 시작한다. 모델이 만든 메뉴를 사람이 고치고, 원래 출력과 수정본 사이의 차이를 확인한다. 학습 중에는 모델 출력을 ground truth와 비교해 오류율을 계산하고, 그 값을 손실 또는 보상 신호로 삼아 직접 줄인다. 사람이 메뉴를 수정하는 단계는 4:42, 오류율을 수치화해 최적화하는 단계는 4:47에 설명된다.
이 루프를 구조로 쓰면 모델 출력 → 사람의 교정 → 정답과 오류 유형 → grader 또는 reward → 새 모델 출력이 된다. 사람이 매번 모든 메뉴를 대신 작성하는 것과 다르게, 반복되는 판단을 측정 가능한 신호로 바꾸려는 접근이다. Applied Compute의 공식 DoorDash 사례도 자동 grader가 내부 전문가의 검증 기준을 포착하고, 그 점수를 reward function으로 사용했다고 설명한다. 다만 이 자료 역시 회사가 작성한 case study이므로 독립 재현으로 볼 수는 없다. Applied Compute의 DoorDash case study
Patil은 이 사례를 두고 기업이 좋고 나쁨을 정의하면 프롬프트 조정 없이 원하는 결과를 직접 최적화할 수 있다고 결론 낸다. 발표의 결론은 5:04–5:17에 나온다. 이 결론은 모든 기업 과제에 자동으로 적용되지 않는다. 결과를 일관되게 채점할 수 있고, 사람의 수정이 실제 품질을 대표하며, 학습 후에도 새로운 메뉴 형식에 일반화되는지 검증할 수 있어야 한다.
더 나은 미래 모델을 기다리는 대신 지금의 기준을 학습한다
진행자는 가상의 ‘GPT-17’이 기본 상태에서 훨씬 나아질 수 있는데 왜 지금 모델을 특화해야 하느냐고 묻는다. GPT-17은 실제 제품명이 아니라 인터뷰 중 즉석에서 든 미래 모델의 예다. 질문은 5:52–6:08에 나온다.
Patil의 답은 효과를 얻기까지의 시간이다. 기업은 먼 미래의 최고 모델보다 현시점에서 사용할 수 있는 최고 수준을 원한다는 주장이다. 그는 데이터가 여러 조직과 시스템에 흩어져 있으므로 하나의 모델이 모든 것을 통제하는 세상도 오지 않을 것이라고 전망한다. 현시점의 frontier를 원한다는 답은 6:12, ASI와 분산된 데이터에 관한 전망은 6:24–6:39에 이어진다.
여기서 기다림의 비용은 모델 성능만으로 계산할 수 없다. 현재 업무의 오류 비용, 사람이 교정하는 시간, 다음 범용 모델의 출시 시점, 새 모델로 바꿀 때 eval과 grader를 재사용할 수 있는지도 함께 봐야 한다. 기업별 eval과 교정 데이터는 기초 모델이 바뀌어도 남을 수 있는 자산이다. 이 문장은 발표의 논리를 운영 의사결정으로 확장한 해석이며, 영상은 실제 교체 비용이나 투자 회수 기간을 제시하지 않는다.
연산 효율과 성능 향상은 조건이 빠진 회사 주장이다
마지막에 Patil은 현재 RL에 필요한 연산량이 pre-training 같은 다른 학습의 대략 10분의 1 수준이며, SFT나 RLHF보다 성능을 훨씬 더 높일 수 있다고 말한다. 그는 이 점이 지금 자체 모델을 학습하는 ROI와 효과를 얻기까지의 시간을 매력적으로 만든다고 주장한다. time-to-value와 ROI는 6:39, 연산량과 성능 비교는 6:50–7:04에 나온다.
이 비교에는 필요한 조건이 빠져 있다. 어떤 크기의 base model을 썼는지, 토큰 수와 rollout 수가 얼마인지, 어떤 하드웨어와 품질 목표를 기준으로 삼았는지, pre-training, SFT, RLHF의 범위를 어디까지 포함했는지가 공개되지 않았다. 따라서 ‘10분의 1 비용’이나 ‘항상 더 높은 성능’이라는 보편 법칙으로 옮길 수 없다. 이 글은 발표자의 경제성 주장으로만 기록한다.
영상에서 더 단단하게 남는 부분은 숫자보다 학습 구조다. 기업 내부 지식은 문서 묶음만으로 표현되지 않는다. 좋은 결과의 기준을 eval로 만들고, 사람의 수정을 ground truth와 오류 유형으로 정리하고, 학습 데이터와 시험 데이터를 나누고, 새 실패가 생길 때 eval을 갱신해야 한다. 특화 모델의 가치는 이 루프가 실제 업무 품질을 안정적으로 예측하는지로 판단해야 한다.
회사별 평가표에는 정확도뿐 아니라 비용과 지연 시간도 들어간다
별도의 인터뷰에서 Patil은 OpenAI의 post-training 경험을 기업별 모델 사업으로 연결한다. 먼저 원하는 능력을 eval로 정하고, 그 과제를 연습할 고품질 학습 데이터를 만든다는 순서다. 그는 Microsoft의 추론 모델 연구를 떠올리며 RL을 ‘정해진 언덕을 오르는 기계’에 비유한다. 여기서 알고리즘이 작동한다는 말은 발표자의 설명이지, 어떤 평가표든 좋은 결과를 보장한다는 증명은 아니다. 인터뷰 0:00–0:53
회사마다 오를 언덕도 달라진다. 답이 얼마나 똑똑한지뿐 아니라 어느 비용과 지연 시간 안에 답해야 하는지, 어떤 입력 형식을 다뤄야 하는지도 평가 조건에 포함된다. 진행자가 eval을 새로운 PRD에 비유하는 이유다. 제품 요구사항이 설명문에 머물지 않고, 후보 모델이 충족해야 할 측정 가능한 기준이 되는 셈이다. Patil은 이런 기준이 회사 내부에 남아 있다면 그 기준에 맞게 post-training하는 능력도 회사가 소유하고 싶어 할 것이라고 주장한다. 회사별 eval과 비용 조건 0:53–1:47, 평가표와 소유권 1:47–2:31
이 설명을 구현 조건으로 풀면 평가표는 단일 정확도 점수보다 제약이 있는 선택 문제에 가깝다. 더 정확하더라도 제한 시간 안에 끝내지 못하거나 허용 비용을 넘으면 해당 업무에는 부적합할 수 있다. 반대로 작은 모델이 비용을 줄였어도 중요한 예외를 놓치면 성공으로 볼 수 없다. 이 문단은 인터뷰의 비용과 지연 시간 조건을 기술적으로 해석한 것이다. ‘eval처럼 생긴 데이터를 만든다’는 발언을 시험 문제를 그대로 학습에 넣으라는 지시로 읽어서는 안 된다. 앞서 Stanford 강연에서 설명한 학습 표본과 시험 표본의 분리 조건은 여전히 필요하다.
이 Short는 인터뷰 중 고품질 학습 데이터, 비용과 지연 시간을 포함한 평가 기준, 회사별 후속 학습을 설명하는 1분 23.44초 구간이다. 최첨단 범용 모델의 유용성도 인정하며, 특정 업무에 맞출 선택권이 필요하다는 주장으로 이어진다. 해당 Short 전체 구간
모델을 소유하는 이유는 토큰 비용과 업무 맥락에서 갈린다
인터뷰 진행자는 범용 모델과 특화 모델의 성능 차이가 줄어드는 상황에서, 특화의 이유가 성능보다 비용으로 이동했는지 묻는다. Patil은 당시 고객이 가장 먼저 생각하는 요인은 비용이라고 답한다. 그가 ‘token apocalypse’라고 부르는 상황도 과업에 맞는 모델을 골라야 한다는 주장의 배경이다. 이 표현은 인터뷰의 진단이며, 영상에 가격 추이나 고객별 비용 비교표가 제시되지는 않는다. 비용에 관한 문답 2:31–3:17
그렇다고 차별화의 논지가 사라진다는 뜻은 아니다. Patil은 Kirkland & Ellis가 경쟁사가 쓸 수 없는 AI 도구를 위해 약 5억 달러를 쓰려 한다는 이야기를 들며, 정확한 인용은 기억나지 않는다고 덧붙인다. 이어 모델 자체뿐 아니라 회사의 harness 안에서 고유한 context를 사용해 학습하는 것이 차이를 만든다고 주장한다. 지출 계획의 금액과 취지는 이 인터뷰의 재진술로만 다루며, 이 글이 확인한 투자 실적은 아니다. 로펌 사례와 harness 논의 3:17–4:01
여기서 소유권은 가중치 파일 하나를 갖는 문제보다 넓다. 회사가 도구와 데이터 접근 방식을 바꾸면 같은 모델도 다른 결과를 낸다. 따라서 특화 모델을 비교할 때는 base model, 학습 데이터, eval, 실제 harness의 조건을 함께 기록해야 어느 변화가 개선을 만들었는지 알 수 있다. 모델이 기업 내부 업무를 배웠다는 주장도, 회사가 원하는 결과를 같은 조건에서 더 잘 내는지 확인해야 의미가 생긴다. 이는 인터뷰의 차별화 주장을 실험 설계로 옮긴 해석이다.
이 대목 끝에는 창업 후 약 1년, 기업가치 13억 달러라는 문답도 나온다. 진행자가 수치를 제시하고 Patil이 짧게 호응한다. 제품의 성능이나 고객 경제성을 입증하는 자료는 아니므로 사업 배경에 관한 인터뷰 발언으로 구분한다. 사업 현황 문답 4:01–4:14
더 읽을 자료
- Stanford MS&E435 강연 원본이 글은 원본 23:59.44–31:03.84 구간만 다룬다.
- RLDR 한국어 자막 공개본본문 시간 링크의 기준 영상.
- SWE-bench: Can Language Models Resolve Real-World GitHub Issues?SWE-bench의 과제 구성과 평가 목적을 확인한 1차 논문.
- Applied Compute DoorDash case studygrader와 reward loop를 설명한 회사 사례. 독립 재현 자료가 아니다.
- Datafooding Applied Compute research noteApplied Compute의 여러 공개 자료를 분리해 정리한 배경 자료.
- Yash Patil 인터뷰 원본원본 35:39.8–42:45.52를 별도로 대조했다.
- 회사별 eval과 소유권의 RLDR 공개 편집본