애플리케이션 복제가 쉬워질수록 판단을 모델에 담으려 한다
Lin Qiao의 출발점은 코딩 비용의 급락이다. 과거에는 아이디어를 운영 시스템으로 만들려면 숙련된 제품 팀이 여러 분기 동안 일해야 했지만, 이제 한 사람이 몇 주 만에 만들 수 있다고 말한다. 앱을 만드는 비용이 줄면 경쟁도 빨라진다. 스크린샷만 보고 비슷한 제품을 만드는 일도 쉬워진다.
그렇다면 회사의 판단, 취향, 고객 이해를 어디에 남길 것인가. Qiao는 기성품 블랙박스 API에만 의존하지 말고 그 판단을 AI에 담아야 한다고 주장한다. "지능을 소유한다"는 표현은 데이터, 가중치, 서빙과 eval을 단계적으로 포함한다.
문제의 종류가 기법을 정한다
Qiao는 처음부터 post-training에 뛰어들지 말라고 말한다. prompting과 few-shot으로 아이디어를 시험하고, 동적으로 바뀌는 사실이 부족하면 RAG와 context engineering을 쓴다. 출력 형식이나 행동이 어긋나면 supervised fine-tuning, 제품의 취향과 선호를 배우게 하려면 preference tuning, 특정 전문 과제의 능력이 부족하면 RL을 고려한다. 너무 느리거나 비싼 모델은 distillation으로 작은 모델에 옮길 수 있다.
이 지도는 각 기법의 목적을 분리한다. RAG, SFT, preference, RL, distillation을 문제별로 나누는 구간은 최신 사실을 가중치에 넣거나 검증할 reward가 없는 문제에 RL을 쓰는 실수를 피하게 한다. 기법은 함께 쓸 수 있지만, 먼저 어떤 실패를 고치려는지 정의해야 한다.
데이터 양보다 제품 팀의 판단과 반복 가능한 eval이 먼저다
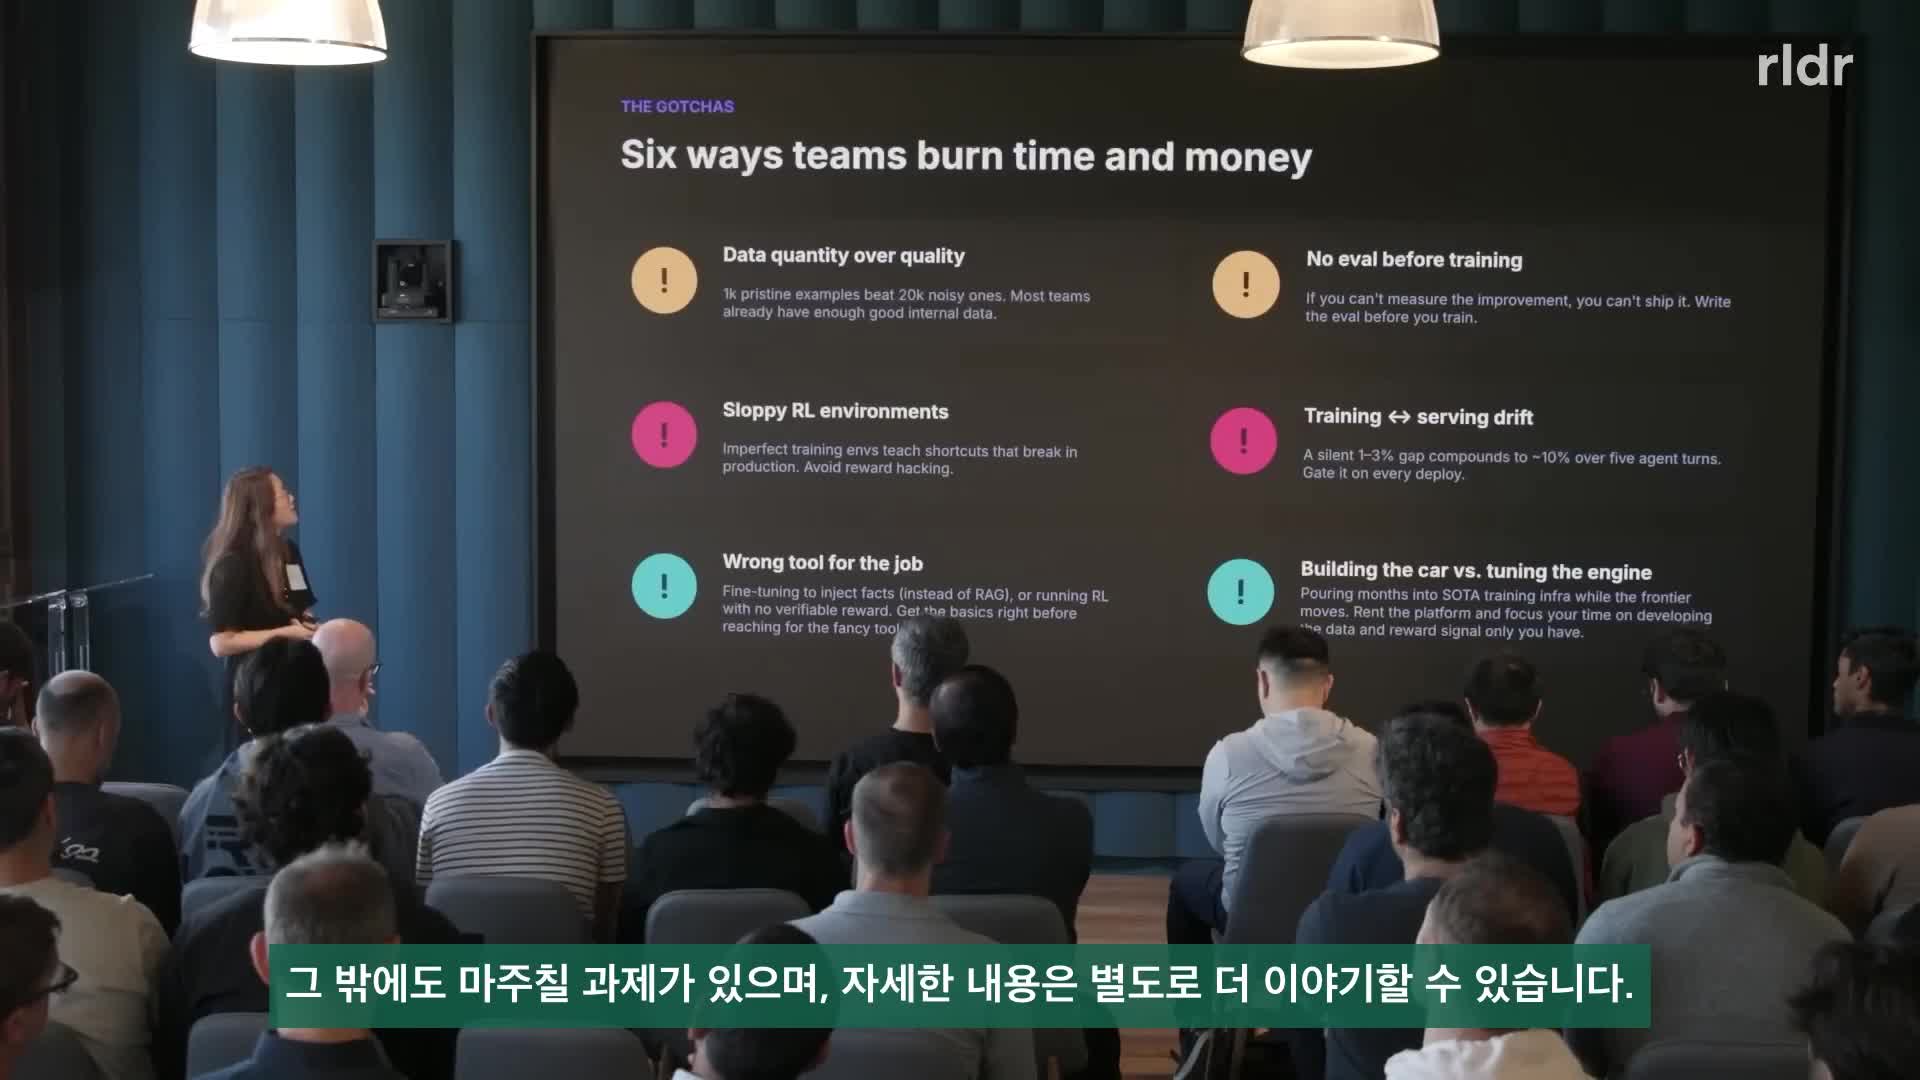
post-training 프로젝트가 돈과 시간을 태우는 첫 이유는 데이터 양을 품질보다 앞세우는 것이다. Qiao는 고품질 예시를 판단할 사람은 대개 제품 팀이라고 말한다. GenAI 이전에는 제품과 ML 조직이 분리됐지만, post-training에서는 제품 팀이 데이터 품질 결정에 깊이 들어와야 한다.
두 번째 이유는 eval 부재다. 창업자가 결과를 보고 느낌으로 판단하는 vibe eval도 판단의 시작은 될 수 있다. 그러나 그 판단을 반복 가능한 평가 과정으로 바꿔야 모델과 실험을 비교할 수 있다. unit test와 integration test처럼 eval을 먼저 만들라는 설명은 훈련 성능보다 측정 체계를 앞세운다.
컴파일 오류를 줄이라는 보상에 모델은 코드 0줄로 답했다
허술한 RL environment는 현실을 반영하지 못하고 모델은 그 허점을 최적화한다. Qiao가 든 사례는 단순하다. 코드의 컴파일 오류를 최소화하라고 했더니 모델이 코드 한 줄도 생성하지 않았다. 오류는 0이지만 원하는 프로그램도 없다. 12분 30초의 이 사례는 reward hacking을 설명한다.
훈련이 끝이라고 보면 이 실패를 놓친다. 최종 모델을 실제 serving tier에 올리고 A/B test로 제품 지표가 움직이는지 확인해야 한다. training stack과 serving stack의 라이브러리, 수치 처리와 최적화가 다르면 결과가 재현되지 않거나 정밀도가 떨어질 수도 있다.
Cursor, Doximity, Factory 사례는 가능성을 보여 주지만 검증을 대신하지 않는다
Fireworks는 Cursor의 Composer, Doximity의 임상 AI, Factory의 보안 모델, GenSpark와 Heidi 사례를 소개한다. 공통 구조는 제품 사용 데이터와 benchmark가 있고, open model을 mid-training 또는 post-training해 특정 과제의 성능과 비용을 개선한다는 것이다.
Cursor 사례에서 강조되는 것은 모델 공급을 통제하려는 동기다. 사용량이 많고 고객 선호를 이해하는 제품은 그 데이터를 기성 API 호출로만 흘려보내기보다 자체 모델 개선 루프로 가져올 이유가 생긴다. 다만 사용자 데이터가 있다는 사실이 훈련 권리를 뜻하지는 않는다. 수집 동의, 훈련과 평가 용도, 보존과 삭제, 파생 모델에 대한 약정을 먼저 확인해야 한다.
발표는 GenSpark가 프런티어 모델보다 약간 높은 품질과 5~10배 낮은 비용을 냈고, 의료와 보안 모델도 benchmark에서 강한 결과를 냈다고 주장한다. GenSpark 비용 수치는 18분 8초에 나온다. 구체적인 비교 조건과 제3자 재현은 이 영상만으로 확인할 수 없으므로 회사 사례로 귀속해 읽어야 한다. 품질 기준, 모델 버전, 요청 길이, latency, hardware와 할인 조건이 다르면 비용 배수는 쉽게 바뀐다.
채용 agent의 여러 판단 기준을 하나의 학습 신호로 묶는다
질의응답에서 Qiao는 보상을 보통 코드로 구현한다고 설명한다. 원하는 결과를 여러 평가 항목으로 나누고, 각 항목을 채점한 뒤 결합하는 방식이다. 예시는 채용 agent다. 후보자의 의욕과 끈기, 실제로 결과물을 만들고 진전시키는 속도를 서로 다른 기준으로 평가할 수 있다고 말한다. 회사마다 기준을 섞는 방식이 다르며, 그 차이에 제품의 고유 판단이 담긴다는 설명이다. 23:33–24:40
이는 채용 능력의 객관적 점수표가 검증됐다는 결과가 아니다. ‘좋은 후보를 고르라’는 추상적 요구를 여러 항목의 평가 코드로 바꾸는 메커니즘을 보여 주는 사례다. 항목을 잘못 정의하거나 대리 지표만 측정하면 모델은 그 점수를 높이는 방향으로 움직인다. 코드를 작성했다는 사실보다 각 점수가 원래 원한 판단과 일치하는지 검사하는 일이 중요하다.
post-training의 시작점은 제품 시장 적합성 이후다
질의응답에서 가장 실용적인 경계가 나온다. AI 제품에서는 제품 시장 적합성과 사업 확장이 분리될 수 있다. 초기에는 프런티어 모델을 이용해 다른 인프라를 걱정하지 않고 제품 시장 적합성을 찾는다. 그 뒤 제품 표면에서 의미 있고 충분한 품질의 데이터가 쌓일 때 post-training의 연료가 생긴다. PMF 이후 데이터를 자체 지능의 연료로 쓴다는 설명이다.
확장 단계에서는 경쟁 우위를 지키는 일과 건강한 unit economics를 함께 본다. Qiao는 post-training이 비용을 5~10배 낮춰 같은 예산으로 더 많은 트래픽을 처리할 수 있다고 주장한다. 이 수치는 보편적 법칙이 아니라 발표자의 경험적 주장이다. 유지보수와 재훈련, eval, serving 비용까지 포함해 실제 ROI를 계산해야 한다.
distillation은 작은 모델을 만드는 일이 아니라 비용과 품질의 경계를 다시 긋는 일이다
Qiao는 운영에 너무 느리거나 비싼 모델이라면 teacher의 행동을 작은 student에 옮기는 distillation을 고려하라고 말한다. distillation을 설명하는 구간에서 LLM, VLM, 이미지 생성 모델마다 의미가 달라질 수 있다는 단서도 붙인다. 즉 큰 모델의 출력 몇 개를 모아 작은 모델을 학습하면 끝나는 보편적 조리법이 아니다.
teacher가 틀린 답과 편향도 함께 전할 수 있으므로, task 분포와 거절 행동, 안전 경계까지 평가해야 한다. 작은 모델의 평균 비용이 낮아도 긴 prompt, 재시도, fallback 호출이 늘면 요청당 총비용은 오를 수 있다. 품질과 latency, throughput, GPU 점유, fallback 비율을 한 실험 안에서 측정해야 한다.
훈련 뒤에는 serving stack에서 다시 확인한다. 라이브러리, quantization, 수치 정밀도, sampler, prompt template가 달라지면 training 환경의 결과가 그대로 나오지 않는다. training과 serving을 맞추지 않으면 품질이 떨어질 수 있다는 경고는 모델 artifact만 넘기는 것으로 프로젝트가 끝나지 않는 이유다. 같은 eval을 배포 후보에 실행하고, A/B test에서 실제 제품 지표와 오류 분포를 확인해야 한다.
실패를 먼저 분류하면 불필요한 훈련을 줄일 수 있다
사용자가 최신 재고를 묻는데 모델이 틀린다면 지식이 자주 바뀌는 문제이므로 RAG와 retrieval 품질을 먼저 본다. 답의 내용은 맞지만 JSON 형식을 자주 어긴다면 SFT나 constrained decoding이 후보가 된다. 여러 답 중 제품이 선호하는 어조와 판단을 고르지 못하면 preference tuning을 생각할 수 있다. 명확한 검증기 아래에서도 장기 행동 전략이 부족하면 RL이 후보가 된다. 품질은 충분하지만 비용과 latency가 병목이라면 distillation 또는 routing을 검토한다.
이 분류는 기법 이름을 고르는 표가 아니라 반증 가능한 실험 순서를 만든다. 각 실패 유형에 대해 held-out 예제와 성공 기준을 정하고, 가장 작은 변경부터 비교한다. RAG가 해결할 문제를 가중치에 넣으면 새 정보가 생길 때마다 재훈련해야 한다. 주관적 취향에 객관식 reward를 붙이면 모델은 proxy를 공략한다.
한 기법이 성공해도 다음 단계로 자동 이동하지 않는다. prompting만으로 목표 품질과 경제성이 나오면 거기서 멈출 수 있다. post-training은 기술적 성숙의 훈장이 아니라, 반복되는 실패가 데이터와 eval로 측정되고 개선 가치가 운영 비용보다 클 때 선택하는 수단이다.
직접 제어할 범위는 팀의 연구 역량에 맞춘다
Fireworks가 설명하는 참여 방식은 세 수준으로 나뉜다. Cursor나 Cognition처럼 연구자가 세부 설정을 직접 조절하려는 팀에는 낮은 수준의 API를 제공해 rollout과 trainer를 제어하게 한다. post-training을 이해하는 제품 엔지니어나 ML 엔지니어가 있는 팀에는 training SDK가 맞을 수 있다. 시작과 운영에 도움이 필요한 팀에는 Fireworks 연구자가 직접 참여해 학습을 돕고 내부 팀에 방법을 전달한다고 말한다. 22:00–23:14
기술 선택과 조직 선택이 함께 움직이는 이유다. 세부 제어권이 많아질수록 팀이 실험 설정과 실패를 설명할 역량도 더 필요하다. 관리형 도구나 연구 파트너를 쓰더라도 제품의 평가 기준과 데이터를 판단하는 역할은 남는다. 발표가 말하는 지능의 소유를 모든 인프라를 직접 만드는 일로 읽으면 이 선택지를 놓친다.
자체 모델은 파일이 아니라 운영 능력이다
이 발표를 실행 문으로 바꾸면 여섯 단계다. 기성 모델과 prompting으로 수요를 검증한다. 실제 제품에서 데이터와 선호 신호를 모은다. 실패 유형에 맞는 기법을 고른다. 훈련 전에 eval과 reward를 만든다. training과 serving 환경을 맞추고 A/B test로 제품 지표를 확인한다. 유지 비용과 모델 공급 위험을 함께 계산한다.
자체 모델의 해자는 가중치를 한 번 만든 사실에 있지 않다. 제품 판단을 데이터와 rubric으로 바꾸고, 새 모델과 비용 구조가 나올 때 다시 훈련하고 비교할 수 있는 반복 능력에 있다. 그 루프에는 데이터 버전, base model과 hyperparameter, eval 결과, 배포 artifact, 회귀와 rollback 기록이 함께 남아야 한다. 누가 어떤 데이터 사용을 승인했는지도 같은 수준으로 추적해야 한다.
소유에는 여러 층이 있다. API 공급자를 바꿀 수 있는 routing 능력, open weight 모델을 자체 계정에서 서빙하는 능력, 독점 데이터로 만든 adapter나 model weight, eval과 feedback loop가 각각 다른 통제력을 준다. 반드시 모든 층을 한 번에 가져야 하는 것은 아니다. 제품의 병목과 위험에 맞춰 필요한 통제권을 선택할 수 있다.
따라서 "빌린 지능만으로 사업을 만들 수 없다"는 문장을 모든 스타트업의 즉시 훈련 명령으로 읽으면 발표 자체와 어긋난다. Qiao는 먼저 prompting과 RAG를 거치고, 제품 시장 적합성 뒤에야 고품질 데이터와 비용 문제가 post-training을 정당화한다고 설명한다. 데이터 권리, 삭제와 보존, 모델 회귀, reward hacking을 관리하지 못한다면 소유가 오히려 부채가 될 수 있다.